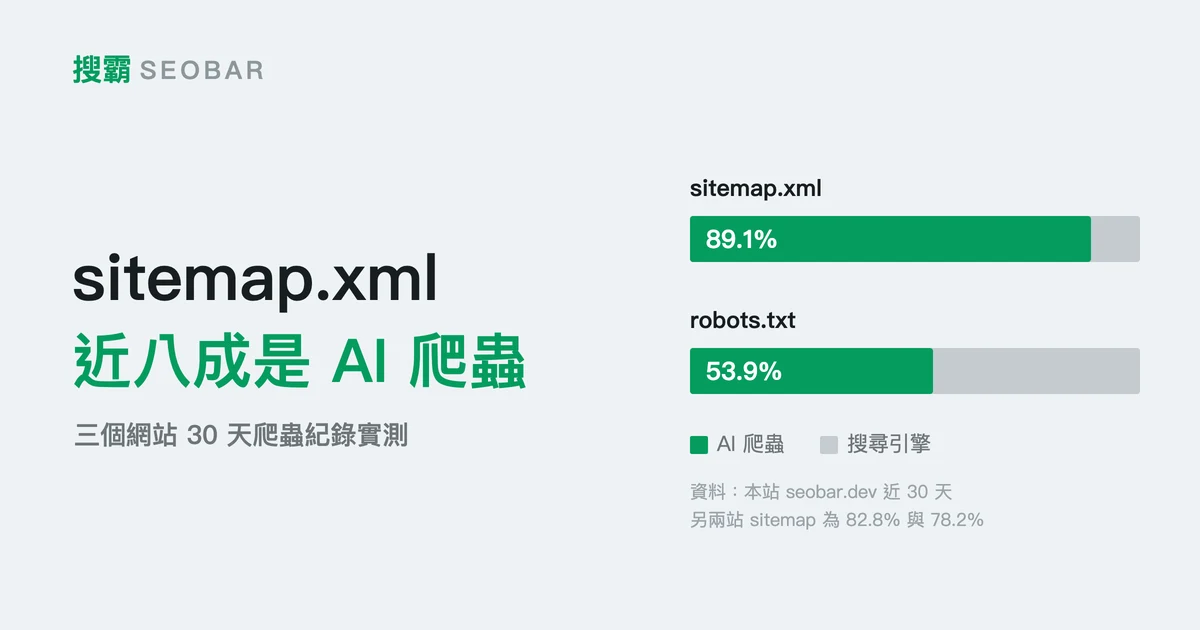
AI 爬蟲實測:sitemap.xml 的爬取有近八成來自 AI 而非搜尋引擎
三個網站近 30 天的爬蟲紀錄:sitemap.xml 上 AI 爬蟲是搜尋引擎的 3.6 到 8.2 倍,同一時間 robots.txt 幾乎一比一。只有 15 頁的新站,更有一半的爬取次數落在這兩個檔案上,沒有讀到任何內容。
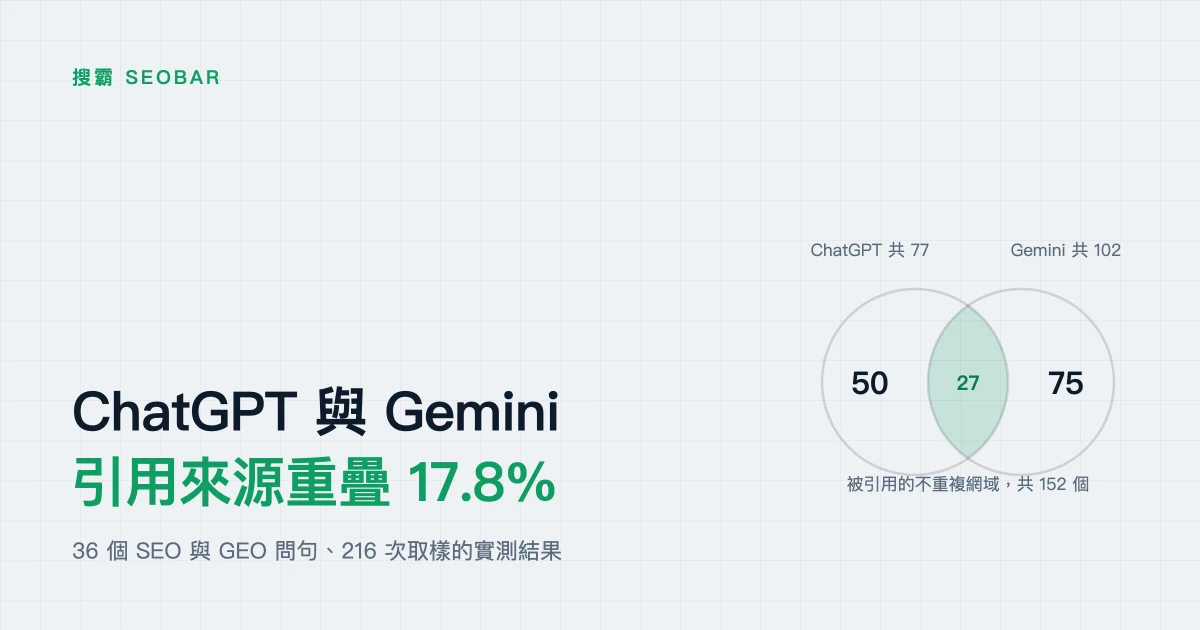
AI SEO/GEO 實測:ChatGPT 與 Gemini 引用來源重疊 17.8%
216 次實測:ChatGPT 與 Gemini 的引用來源重疊率只有 17.8%。問操作與觀念時,ChatGPT 有 96% 不引用任何外部網頁,Gemini 則有三分之二會列出來源。
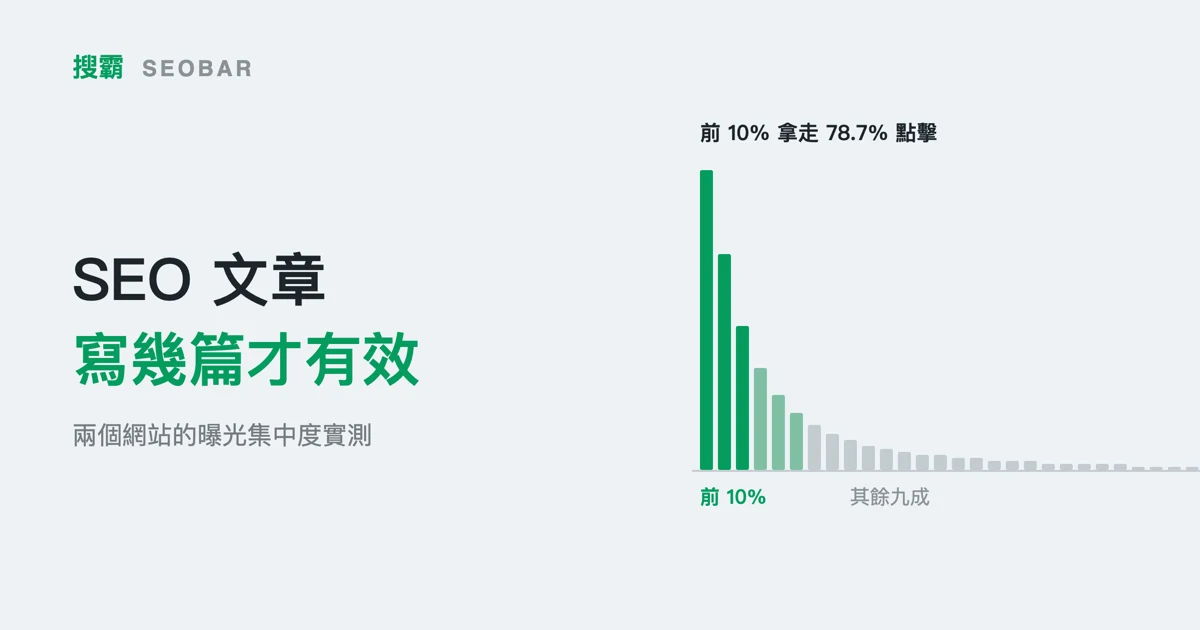
SEO 文章要寫幾篇才有效?兩個網站的曝光集中度實測
SEO 服務多半按篇計價,但文章累積與流量成長並不成正比。兩個網站的實測顯示前 10% 的文章拿走近八成點擊,本文說明這個分布怎麼形成、為什麼合約長成按篇計價,以及判斷要不要再寫一篇的三個問題。
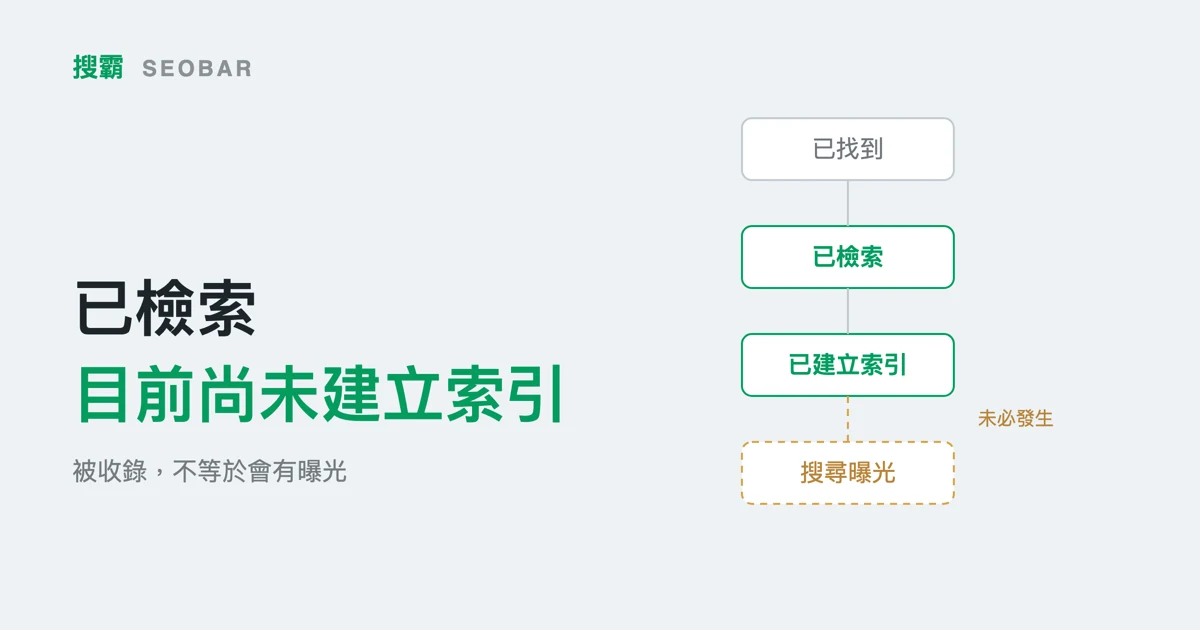
已檢索 - 目前尚未建立索引:狀態定義與排查順序
Google 官方明寫這不是錯誤、不必重新送交檢索。本文說明兩種未建立索引狀態的差別、被收錄卻搜不到的原因,以及為什麼同一頁在 AI 搜尋的處境未必相同。
AI SEO 實測:ChatGPT 開始讀取新網域花了 7 天
上線第 5 天,ChatGPT 對這個新網域回「URL is not safe to open」;第 12 天回測已能正常讀取並正確摘出站台資訊。被 AI 引用之前還有一道抓取准入的門,這是它打開所需時間的實測紀錄。
HTTP 狀態碼與 SEO:301、404、410、503 分別代表什麼
當 Google 的爬蟲收到某個 HTTP status code,它接下來會做什麼。內容對照官方文件,其中兩處與中文圈流傳的說法不同:302 是弱訊號而非完全不移轉,以及 404 與 410 其實被同等對待。另談 soft 404、5xx...
canonical 是什麼?重複網址的判斷與常見設錯
canonical(標準網址)是建議不是命令——Google 文件寫明這是 hint 而非 rule。本文說明重複網址怎麼產生、自我參照為什麼每頁都該有、四種最常見的設錯,以及它與 301 轉址的分工與各自的適用時機。
robots.txt 怎麼寫?語法、常見錯誤與 AI 爬蟲
robots.txt 的語法、規則比對方式與六個常見錯誤。包含最容易誤解的一點:它擋的是爬取,不是收錄;以及實測台灣 21 個網站的 robots.txt,看誰在管 AI 爬蟲、誰完全沒設。
sitemap 是什麼?產生、提交與 Google 實際會讀的欄位
XML sitemap 怎麼產生、怎麼提交,以及 sitemap.xml 裡哪些欄位 Google 根本不會讀。包含 ping 端點停用後剩下的三種提交方式,以及用 xmllint 自行驗證格式時,哪一種錯誤該修、哪一種不必理會。