AI 爬蟲實測:sitemap.xml 的爬取有近八成來自 AI 而非搜尋引擎
TL;DR
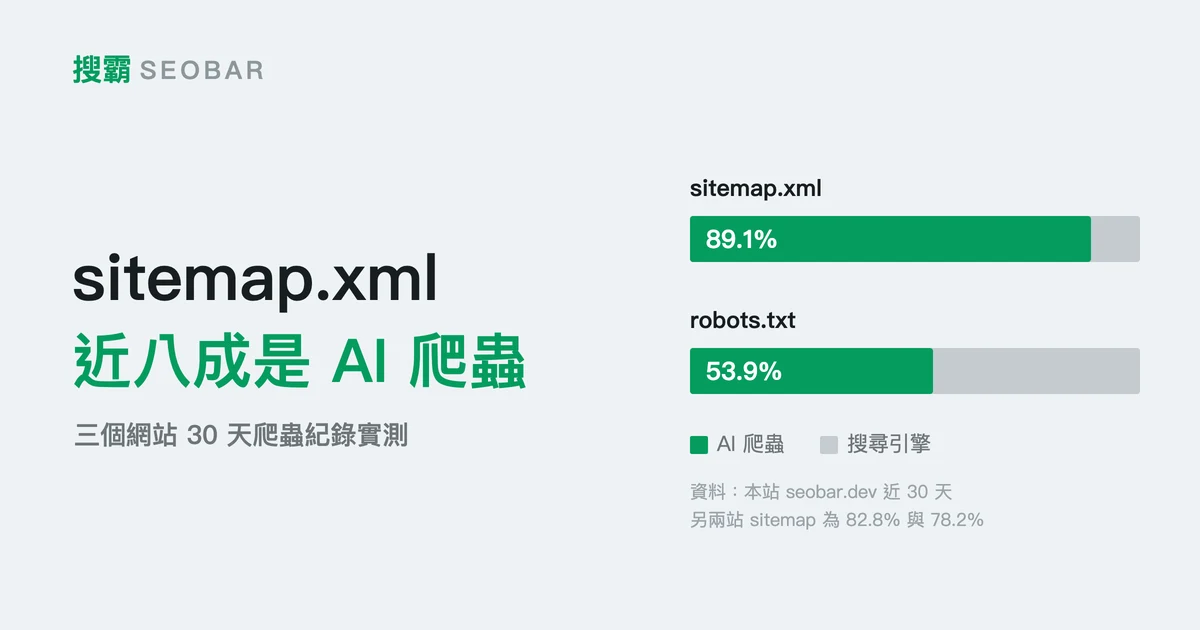
- 三個網站近 30 天的紀錄裡,sitemap.xml 的爬取有 78% 到 89% 來自 AI 爬蟲;同一批資料中,robots.txt 的 AI 與搜尋引擎幾乎各佔一半
- 只有 15 頁的新站,一半的爬取次數落在 robots.txt 與 sitemap.xml 這兩個檔案上,沒有讀到任何內容;頁數較多的兩站是 17% 與 19%
- 單篇文章 30 天被爬 8 到 14 次,首頁被爬的次數是它的數倍到數十倍
- Google 官方文件寫明小型且內鏈完整的網站可以不用 sitemap,這個判準在 AI 爬蟲身上看不到對應的行為
- 多發一篇文章的作用,是在一份被反覆讀取的清單上多一行,不是讓既有文章被讀得更深
目錄
實測環境:三個網站的 30 天爬蟲紀錄
robots.txt 與 sitemap.xml 佔總爬取次數的比例
sitemap.xml 上 AI 爬蟲與搜尋引擎的組成
單篇文章分到的爬取次數
文章數量在爬取端的作用
本次觀測的限制
引言
網站上線之後最難確認的一件事,是 AI 到底有沒有讀到你。Search Console 只回答 Google 那一側,伺服器層的請求紀錄多數站長看不到,於是「要不要為了 AI 做什麼」這個問題往往只能憑感覺回答。
這裡有三個網站同一天取出的近 30 天爬蟲紀錄。原本要查的是哪幾篇文章被抓得最頻繁,最明顯的分布卻不在文章,在 sitemap.xml。
實測環境:三個網站的 30 天爬蟲紀錄
三個網站共用同一套紀錄機制,逐次記下爬蟲請求的來源與路徑。爬蟲身份不只認 User-Agent 字串,另有一層來源驗證,偽造 UA 的請求不列入統計。真人訪客不記錄。
| 網站 | 已被爬到的頁數 | 30 天總爬取次數 |
|---|---|---|
| 本站 seobar.dev(2026-08-27 上線,11 篇文章) | 15 | 844 |
| B 站(經營中的平台型網站) | 62 | 8,006 |
| C 站(經營約三年的公司網站) | 116 | 10,086 |
爬蟲分成三類計算:即時檢索(回答問題時抓取當下的頁面,例如 OAI-SearchBot)、訓練抓取(取內容作為語料,例如 GPTBot、ClaudeBot)、傳統搜尋引擎(Googlebot、Bingbot)。本文提到的「AI 爬蟲」是前兩類的合計。
robots.txt 與 sitemap.xml 佔總爬取次數的比例
先看這兩個檔案佔掉多少爬取次數。兩者都不含內容,一個宣告規則,一個列出網址清單。
| 網站 | robots.txt | sitemap.xml | 合計 | 佔總爬取次數 |
|---|---|---|---|---|
| seobar.dev(15 頁) | 284 | 138 | 422 | 50.0% |
| B 站(62 頁) | 1,082 | 442 | 1,524 | 19.0% |
| C 站(116 頁) | 1,264 | 436 | 1,700 | 16.9% |
新站有一半的爬取次數沒有讀到任何內容,都在反覆確認「這個站有哪些頁、哪些可以抓」。
sitemap.xml 的絕對次數在三站相當接近(138、442、436),robots.txt 則隨站台規模上升。清單被重讀的頻率與站有多少頁,關聯並不明顯。
sitemap.xml 上 AI 爬蟲與搜尋引擎的組成
把這兩個檔案的爬取次數拆成 AI 與搜尋引擎,兩者的落差是這次資料裡最大的一處。
| 網站 | sitemap.xml(AI/搜尋) | AI 佔比 | robots.txt(AI/搜尋) | AI 佔比 |
|---|---|---|---|---|
| seobar.dev | 123 / 15 | 89.1% | 153 / 131 | 53.9% |
| B 站 | 366 / 76 | 82.8% | 597 / 485 | 55.2% |
| C 站 | 341 / 95 | 78.2% | 762 / 502 | 60.3% |
robots.txt 在這裡的角色是對照組:同一個網站、同一段時間、同樣是只有爬蟲會讀的檔案。三站的 robots.txt 都接近一比一,sitemap.xml 卻是 3.6 比 1 到 8.2 比 1。
這排除了「AI 爬蟲總量本來就比較多」這個解釋。以 seobar.dev 為例,全站的 AI 與搜尋引擎比例是 503 比 341,約 1.5 比 1;sitemap.xml 上的 8.2 比 1 遠高於這條基準線。
Google 的官方文件寫明,約 500 頁以下、內部連結完整的網站「可能不需要 sitemap」,因為 Googlebot 跟著連結就找得到。三個網站都在這個門檻內,Googlebot 的行為也與文件一致,它對 sitemap 的取用頻率明顯低於 robots.txt。
AI 爬蟲沒有表現出同一套判準。一個比較合理的解釋是它們缺少 Google 累積二十年的連結圖,發現新網址時能依靠的就是網站自己提供的清單;不過這是推測,這份資料只能證明行為差異存在,證不到原因。sitemap 的產生、提交與 Google 實際會讀的欄位與 robots.txt 的語法與常見錯誤,各有一篇完整說明。
單篇文章分到的爬取次數
剩下的爬取次數分配到內容頁時,頁與頁之間的差距相當大。
seobar.dev 的 11 篇文章,30 天各被爬 8 到 14 次。同一段時間首頁 86 次、關於頁 73 次、文章列表 62 次。B 站首頁一頁就 1,342 次,進入前 50 名排行的 18 篇文章加起來 748 次。C 站首頁 803 次,進榜的 29 篇文章合計 1,601 次。
首頁與列表頁被爬的次數,是單篇文章的數倍到數十倍。首頁是每一輪重新探索的起點,列表頁是新內容出現的位置,兩者的變動頻率都高於單篇文章。
文章數量在爬取端的作用
本站先前量過另一組資料:前 10% 的文章拿走近八成點擊,篇數與流量不成正比。那一組看的是搜尋結果那一端,這一組看的是爬取那一端。
爬蟲每天回來重讀的是清單,不是文章。多發一篇的直接效果,是那份清單上多一行、多一個可能被挑中的入口;它不會讓既有文章被讀得更深,也不會讓整站的爬取次數等比例上升。三站的 sitemap.xml 爬取次數落在 138 到 442 之間,頁數卻相差七倍以上。
至於長尾文章能不能透過內部連結把權重與讀者導向支柱文章,爬蟲紀錄回答不了。它看得到的是入口數量,看不到單篇之間的相互作用,那需要另一組資料。
實務上可以先確認的是清單本身:sitemap.xml 有沒有漏頁、lastmod 有沒有跟著內容更新、robots.txt 有沒有擋掉不該擋的路徑。這三件事的成本遠低於再寫一篇文章,而它們影響的是每一篇。
本次觀測的限制
熱門頁面的統計只取前 50 名路徑,站越大截斷越多。B 站與 C 站的「每篇平均被爬幾次」因此是高估值,只有進榜的文章被算進去;跨站比較只能比比例與排序,不宜比絕對值。
三個網站由同一人維護,用同一套技術架構與同一份 sitemap 產生邏輯,這會讓行為趨同。三個樣本不足以推論到所有網站,特別是 sitemap 產生方式不同、或內鏈結構差異大的站。
被爬取代表 AI 有抓到內容,不代表它在回答時會引用你。這兩件事之間還有好幾道判定,這份資料只涵蓋最前面那一道。
爬蟲的行為會隨各家策略調整而變動,上述比例是一次觀測的結果,不是穩定常數。
常見問題
AI 爬蟲會讀 sitemap.xml 嗎?
會,而且比例遠高於搜尋引擎。三個網站近 30 天的紀錄中,sitemap.xml 的爬取有 78.2% 到 89.1% 來自 AI 爬蟲;同一批資料裡,robots.txt 的 AI 佔比只有 53.9% 到 60.3%。robots.txt 是同站、同時段、同樣只有爬蟲會讀的對照組,這排除了「AI 爬蟲總量本來就比較多」的解釋。
小型網站需要 sitemap.xml 嗎?
Google 官方文件說約 500 頁以下、內部連結完整的網站可能不需要,實測中 Googlebot 的行為也與這個說法一致。但 AI 爬蟲沒有表現出同一套判準:本站只有 15 頁,sitemap.xml 上 AI 與搜尋引擎的比例仍是 8.2 比 1。若希望 AI 讀得到內容,sitemap 的作用高於那份文件所描述的情況。
一篇文章 30 天大概會被爬幾次?
本站 11 篇文章 30 天各被爬 8 到 14 次,同期首頁 86 次、文章列表 62 次。規模較大的兩個網站,首頁分別是 1,342 次與 803 次。這些數字會隨站台規模、更新頻率與各家爬蟲策略變動,不宜當成基準值。
多寫文章可以增加被 AI 爬取的次數嗎?
可以增加入口數量,但不是等比例。三個網站的頁數從 15 到 116 相差七倍以上,sitemap.xml 的爬取次數卻都落在 138 到 442 之間。新增一篇的直接效果是在被反覆讀取的清單上多一行,不會讓既有文章被讀得更深。
被 AI 爬取代表會被 AI 引用嗎?
不代表。被爬取只證明內容有被抓到,之後還有能否被檢索、能否被選為答案來源等判定。本站另一篇實測記錄了新網域從上線到 ChatGPT 能正常讀取所需的時間,那是引用之前的第一道門。
網站一直搜不到,想知道卡在哪一關?
抓取、索引、排名、AI 引用是四道不同的關卡,卡在哪一關決定要做什麼。把網址給我,我用實際量測看一遍再跟你說。
技術 SEO 分類其他文章
繼續閱讀同主題的延伸內容
留言討論
只有會員能留言(防止垃圾訊息),留言顯示於此頁。