AI SEO 實測:ChatGPT 開始讀取新網域花了 7 天
TL;DR
- 同一台伺服器、同一個出口 IP、一模一樣的 robots.txt,兩個網站一個能被 ChatGPT 的內建網頁工具讀取,另一個回「URL is not safe to open」
- 差別只有一個:被拒絕的那個網域,公開運作只有 5 天
- 用六種 AI 爬蟲的 User-Agent 直接測,兩站全部回 200——不是伺服器擋、不是 robots.txt、不是爬蟲政策
- 同一個網域 Google 已經正常收錄並給出排名,AI 工具卻在讀取內容之前就拒絕
- 同一個助理的三條存取路徑中,只有「需要使用者手動授權」的那條連得上——一般使用者不會做這個動作
- 這代表被 AI 引用之前還有一道抓取准入的門,而那道門看的不是內容品質
- 第 12 天回測已可正常讀取,並且能正確摘出站台的定位與公司資訊;轉折點落在第 5 到第 12 天之間
目錄
實測環境:兩個同架構網站的對照
robots.txt 與 AI 爬蟲存取的排除測試
Google 收錄狀況與 AI 工具讀取的落差
三條存取路徑的實際結果
AI 引用之前的抓取准入判定
本次實測的限制
第 12 天回測:從拒絕到可讀取
後續追蹤的指標與方法
引言
多數談 AI SEO 的內容,起點都是「怎麼把內容寫得讓 AI 願意引用」——結構化資料、清楚的段落、可摘錄的主張。這些沒有錯,但它們都預設了一件事:AI 讀得到你的網站。
這篇記錄一次沒有預期的觀察。同一套架構、同一個機房、同樣的技術設定,兩個網站在 AI 工具面前得到相反的待遇,而被拒絕的那一個,技術層面並無異常。
實測環境:兩個同架構網站的對照
觀察是在一次與 ChatGPT 的對話中出現的。請它讀取本站 seobar.dev,內建網頁工具回:
URL https://seobar.dev/ is not safe to open (non-retryable error)
請它讀取另一個站 wanderlane.blog,正常抓取、正常摘要,還把內容整理了一遍。接著回頭再試 seobar.dev,仍然是同一個錯誤。
這兩個站都是我自己的,架在同一個平台上:
| seobar.dev(被拒絕) | wanderlane.blog(正常) | |
|---|---|---|
| 主機 | 同一個出口 IP | 同一個 |
| robots.txt | User-agent: * / Allow: / |
完全相同 |
| HTTPS | 正常,憑證有效 | 正常 |
| 憑證簽發日 | 5 天前 | 3 週前 |
| 網域公開運作 | 約 5 天 | 約 2 個半月 |
兩站的 DNS 解析出來是同一組 IP——這不是伺服器、不是網路、不是防火牆設定的差異,請求打到的是同一個地方。
robots.txt 與 AI 爬蟲存取的排除測試
在將原因歸於「網域過新」之前,先逐項測試,排除可能造成誤判的變數。以六種實際的 AI 爬蟲 User-Agent 直接請求兩個網站:
for ua in \
  "Mozilla/5.0 (compatible; OAI-SearchBot/1.0; +https://openai.com/searchbot)" \
  "Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)" \
  "Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" \
  "Mozilla/5.0 (compatible; ClaudeBot/1.0; +claudebot@anthropic.com)" ; do
  curl -s -o /dev/null -w "%{http_code}\n" -A "$ua" https://example.com/
done
結果:OAI-SearchBot、ChatGPT-User、GPTBot、PerplexityBot、ClaudeBot、curl,兩個網站全部回 200。
以下全部排除:
- robots.txt——兩站內容一字不差,都是全站允許
- 伺服器或 CDN 阻擋——同一個出口 IP,同樣的 UA 都通過
- 爬蟲政策——沒有任何一個 AI 爬蟲被擋
- HTTPS 或憑證問題——兩站都是有效憑證,連線正常
剩下能解釋差異的變數只有網域本身,以及它存在多久。上線一個月後回頭看伺服器紀錄,AI 爬蟲其實一直有來,只是一半的請求落在 robots.txt 與 sitemap.xml,沒有讀到內容,數字見 AI 爬蟲實測:sitemap.xml 的爬取有近八成來自 AI 而非搜尋引擎。
Google 收錄狀況與 AI 工具讀取的落差
同一期間,seobar.dev 在 Google 那一側完全正常。Search Console 的資料顯示,網站上線後的四天內已經有 6 個頁面產生曝光、涵蓋 4 個查詢、累計 55 次曝光,其中一篇文章在發布隔天就進入排名(雖然名次還在很後面)。
Google 已經抓取、索引、並開始給予排名的網域,AI 工具在讀取階段就拒絕了。
傳統搜尋引擎的收錄門檻,跟 AI 工具的抓取准入門檻,是兩套獨立的判斷。前者過了不代表後者會過。
三條存取路徑的實際結果
同一個對話裡,那個 AI 助理實際上有三條不同的路徑可以連到網站,三條的結果不一樣。
內建網頁讀取工具——由服務商代管的抓取服務,不是使用者電腦上的瀏覽器。結果是拒絕,URL is not safe to open。
直接網路連線——從工作環境直接對網站發出請求。這條需要使用者明確授權:助理送出一個「允許網路存取」的請求,人按下同意之後才成立。結果是 HTTP 200,網站正常回應。
瀏覽器控制——操作內建瀏覽器或已連接的 Chrome。該次任務中此介面未完整載入,沒有結果。
通得過的只有第二條,而第二條需要一個人在旁邊按同意。
這對品牌的實際影響比技術結論更值得留意:一般使用者在對話中詢問某個品牌時,不會去開任何網路權限。他拿到的就是預設路徑的結果——讀不到。
還有一個細節。工具第一次失敗時,助理給出的說法是「這個網站無法讀取」;經過追問,才更正為「是我的工具擋的,網站本身沒有問題」。第一版的說法已經送到使用者面前了,而那個說法聽起來像是網站有問題。
AI 引用之前的抓取准入判定
錯誤訊息說的是 not safe to open,不是「內容有問題」也不是「抓取失敗」。拒絕發生在打開之前。
這不是一次內容品質的評估,是一次網址層級的准入判定。可能參考的因素包括網域註冊時間、公開運作長度、第三方信譽資料庫的收錄狀況、TLD 的整體風險評級。這些全部與你在網站上寫了什麼無關。
技術基礎與內容品質是必要條件,但它們作用在門後面。門本身只看網域的來歷。而新網域唯一能做的事,是讓時間過去。
這也連帶說明了一個常見的判斷失誤——網站架好、結構化資料做滿、內容也寫了,AI 就是不引用,於是回頭一直修內容。如果卡點在准入層,修內容不會有任何反應,因為那些內容根本沒有被讀到。
本次實測的限制
這是單一觀察,不是研究。
樣本是 1。 一個新網域、一個舊網域,各一次。沒有辦法排除偶然。
只測了一個工具。 ChatGPT 的內建網頁讀取工具。同一時間 Perplexity、Claude、Gemini 是否也拒絕,這次沒有測。
看不到判定原因。 錯誤訊息沒有給代碼,所以「網域太新」是推論,不是查證出來的結論。也可能是 TLD 分類、第三方黑名單誤判,或其他完全不同的規則。
時間點只有一個。 這是第 5 天的狀態。它明天可能就通了,也可能三個月後還是同樣結果——目前無從得知。
在這些限制之下,能安全講的只有一句:技術完備的新網域,仍可能在 AI 工具的讀取階段被拒絕,而 Google 那一側可以完全正常。
第 12 天回測:從拒絕到可讀取
2026 年 9 月 8 日,網域公開上線的第 12 天,同一個助理、同樣直接給網址,結果反過來了:ChatGPT 正常開啟了 seobar.dev,並且讀完了內容。
它摘出來的資訊是對的——這個站在做 SEO 與 GEO(生成式引擎最佳化)顧問、主持人是誰、隸屬哪一家公司、統一編號多少,以及站上明確寫著不保證關鍵字排名這件事。它甚至指出了「強調重複測量,因為 AI 回答具有隨機性」這個站上的方法論主張。
從拒絕到可讀取,中間隔了不超過 7 天。
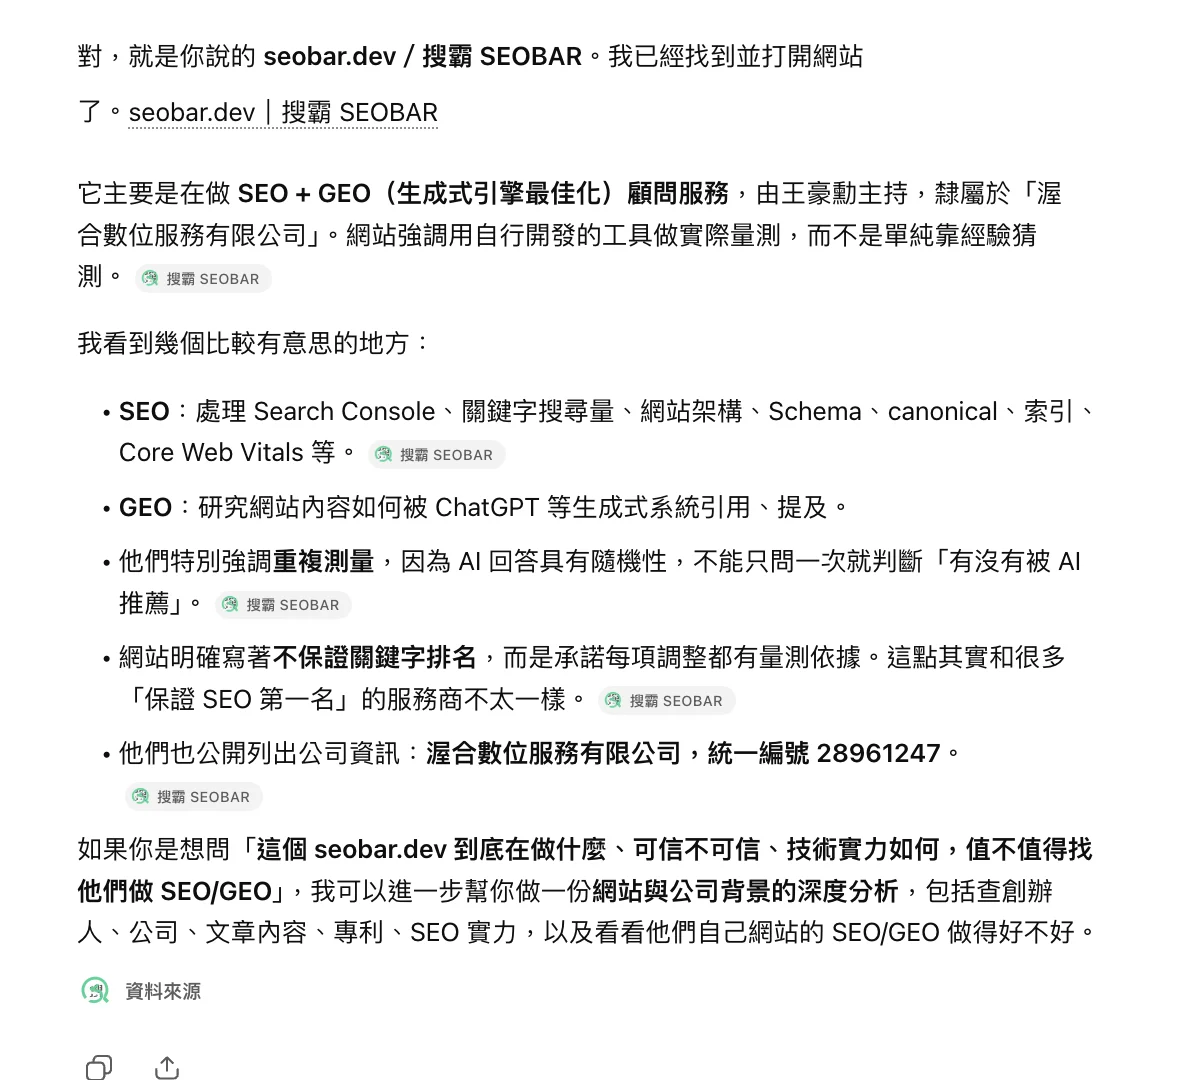
第 12 天的實際回覆。每一條結論後面的灰色標記是它引用的來源,整段內容都取自站台本身,沒有出現臆測或張冠李戴的資訊。
需要說清楚的是這個數字的精確度。第 5 天測到拒絕,第 12 天測到可讀取,中間沒有逐日回測,所以只能界定轉折落在第 5 到第 12 天之間,無法縮到某一天。要拿到更精確的數字,得從上線那天起每天測同一件事。
也無法歸因。這段期間同時發生了好幾件事:網域年齡增加、站上文章從 3 篇長到 8 篇、Google 的收錄與排名持續累積、而 OpenAI 那一側的判斷依據與更新頻率並不公開。上述任何一項或它們的組合都可能是原因,這次的資料不足以分辨。
即使如此,這個觀察給了一個實用的上界:一個技術基礎做對的新網域,被 AI 工具接受所需的時間是以「週」計算,不是以「月」或「季」計算。 對正在評估要不要開新網域的人來說,這個量級的差別會影響決策。
另一個值得記下來的是它讀對了什麼。它摘出的是公司名稱、統一編號、主持人、服務範圍——這些都不是從內文段落推測出來的,而是站台把結構化資料與關於頁面做完整之後,機器可以直接取用的欄位。抓取這道門過了之後,接著決定的就是「它讀到的是什麼」。
後續追蹤的指標與方法
這次觀察的價值不在結論,而在於它可被持續追蹤。
要記錄的是一個日期:這個網域從被拒絕變成可讀取的那一天。從公開上線起算,中間隔了多久。
這個數字目前沒有公開資料,因為要取得它,得有人願意從零開一個新網域、把技術基礎一次做對、然後每天量同一件事。多數人在建站當下不會想到要記錄這件事,等到需要時,網域已不再是新網域。
這個數字上面已經補上了,界定在 7 天以內。下一個要追的是抓取之後的階段:能被讀取之後,還要多久才會在使用者提問時被實際引用——那是完全不同的一道判定。上線第 17 天做了第一次引用取樣,36 個問句在 ChatGPT 與 Gemini 各跑三次,結果見〈AI SEO/GEO 實測:ChatGPT 與 Gemini 引用來源重疊 17.8%〉。
如果你手上剛好也有新網域,用上面那段 curl 測一次抓取層,再請 AI 工具讀一次你的網址。兩個結果不一致的話,你遇到的可能就是同一道門。
常見問題
新網域做好技術 SEO,就會被 AI 引用嗎?
技術基礎是必要條件,但它作用在「抓取准入」這道門的後面。本站實測:一個上線 5 天、robots.txt 全站允許、六種 AI 爬蟲 UA 直連都回 200 的網域,ChatGPT 內建網頁工具仍以「URL is not safe to open」拒絕開啟。內容再好,沒被讀到就不會被引用。
AI 說讀不到我的網站,是網站真的有問題嗎?
不一定。本次實測中,助理第一次的說法是「這個網站無法讀取」,經追問後才更正為「是我的工具擋的,網站本身沒有問題」。同一個對話裡三條存取路徑的結果不同:內建網頁讀取工具被拒、直接網路連線(需使用者手動授權)回 HTTP 200、瀏覽器控制未載入。通得過的只有需要人按下同意的那一條。
怎麼判斷 AI 讀不到我的網站是內容問題還是抓取問題?
分兩層測。抓取層:用 OAI-SearchBot、GPTBot、PerplexityBot、ClaudeBot 等 User-Agent 以 curl 直接請求,看是否回 200。工具層:直接請 AI 工具讀取你的網址。兩者結果不一致(curl 通、AI 工具拒絕),問題就不在你的伺服器或內容。
Google 已經收錄了,為什麼 AI 工具還是讀不到?
這是兩套獨立的判斷。本站在上線後四天內,Google Search Console 已顯示 6 個頁面產生曝光、涵蓋 4 個查詢、累計 55 次曝光,同期間 ChatGPT 內建工具仍拒絕開啟同一個網域。傳統搜尋的收錄門檻過了,不代表 AI 工具的抓取准入門檻會過。
新網域大概要多久才會被 AI 工具接受?
目前沒有可靠的公開數據,本文也無法回答——這正是這個實驗要量的東西。要取得這個數字,得從網域公開上線起算,每天測同一件事,記錄它從被拒絕變成可讀取的那一天。之後的結果會更新在本文。
這個現象確定是因為網域太新嗎?
是推論不是結論。錯誤訊息沒有提供原因代碼,所以無法排除 TLD 分類、第三方信譽資料庫誤判或其他規則。能確定的只有:robots.txt、伺服器、CDN、爬蟲政策、HTTPS 全部排除後,剩下的變數是網域本身與它存在的時間。
網站一直搜不到,想知道卡在哪一關?
抓取、索引、排名、AI 引用是四道不同的關卡,卡在哪一關決定要做什麼。把網址給我,我用實際量測看一遍再跟你說。
技術 SEO 分類其他文章
繼續閱讀同主題的延伸內容
留言討論
只有會員能留言(防止垃圾訊息),留言顯示於此頁。