FAQ、Schema 能提高 AI 引用嗎?46 萬筆引用的 GEO 研究
TL;DR
- 多倫多大學 2026 年 10 月發表的研究,分析 ChatGPT、Gemini、Perplexity 連續 90 天回答商業問題的紀錄,共 15.8 萬則回答、46.8 萬筆引用
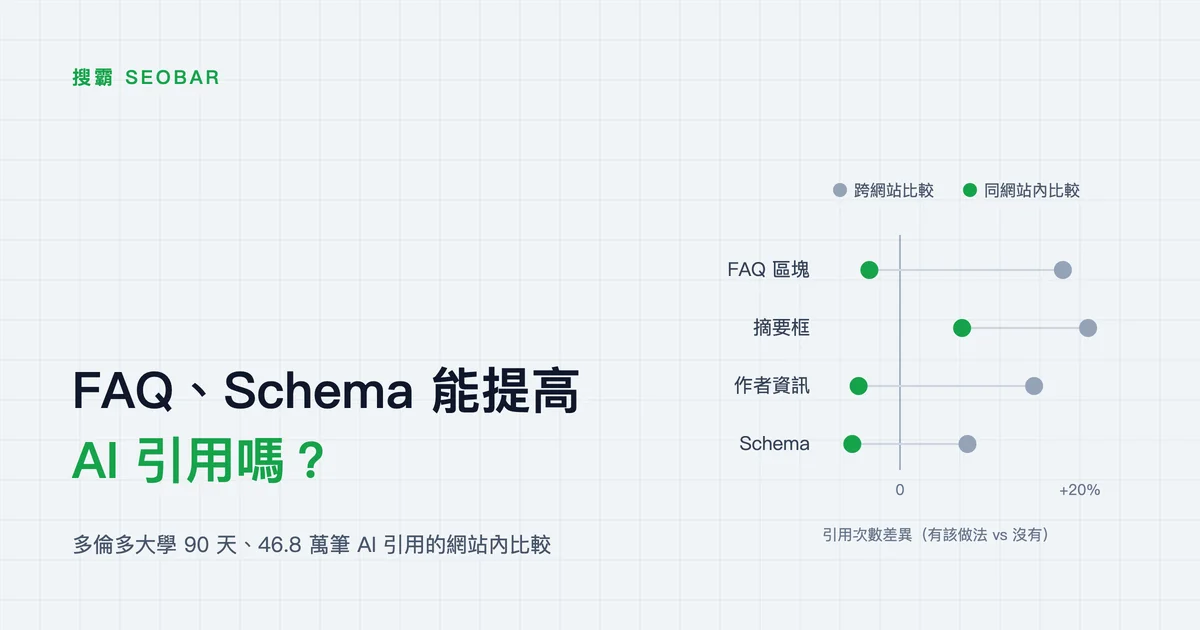
- 跨網站比較時,FAQ 區塊、Schema 標記、作者框、摘要框都與較多的 AI 引用相關;改成同一網站內的頁面互相比較,這些做法全部不再顯著
- 通過全部五項穩健性檢定的頁面特徵只有兩個:標題與最相關段落是否對準使用者的提問
- ChatGPT 引用的每一頁都來自它自己的檢索結果,而這些頁面有 97% 不在 Google 前 50 名。檢索能解釋 32% 的引用差異,頁面特徵只有 2.8%
- 模型對品牌的既有認知會影響檢索與回答:ChatGPT 有 47% 的引用來自它不經搜尋就能說出的網站
- 研究使用 API 與英文、美國市場的問句。與台灣消費介面的實測對照,引擎差異、推薦型問題倚重第三方名單、來源快速流動三項方向一致;FAQ 與 Schema 的結論仍待中文環境驗證
目錄
研究設計:90 天、46.8 萬筆 AI 引用
FAQ、Schema 與作者框:跨網站與同網站比較的落差
與 AI 引用相關的頁面特徵:標題與段落對準提問
AI 檢索與 Google 排名的差異
品牌知名度對 AI 推薦的影響
與台灣 AI 引用實測的對照
研究限制與利益揭露
對 GEO 內容配置的實務意義
引言
目前流通的 GEO(生成式引擎最佳化,讓內容更容易被 AI 回答引用的做法)建議,大致收斂成一張清單:加 FAQ 區塊、補 Schema 結構化資料、放作者資訊、開頭寫一段摘要、提升頁面速度。清單上的每一項都有數據支持,常見的形式是「有 FAQ 的頁面,被引用次數多出若干百分比」。
採用這些做法的,多半是本來就經營得比較完整的大型網站,而大型網站被引用得多,原因可能與 FAQ 毫無關係。把有做與沒做的頁面直接相比,量到的可能只是網站之間的差距。
多倫多大學 Mahe Chen 與 Nick Koudas 於 2026 年 10 月 10 日發表在 arXiv 的論文〈What Drives AI Citations? Content, Retrieval and Model Knowledge in Generative Engine Optimization (GEO)〉,處理的正是這個問題。他們只拿同一個網站裡的頁面互相比較,網站本身的影響因此被排除在外。結果是清單上的做法全部失去效果。
研究設計:90 天、46.8 萬筆 AI 引用
研究團隊每天透過官方 API(應用程式介面,程式直接呼叫 AI 模型的管道)向三個引擎送出相同的問題,並開啟網路搜尋:
| 引擎 | 研究使用的模型與搜尋設定 |
|---|---|
| ChatGPT | GPT-5.4 nano,附網路搜尋工具 |
| Gemini | Gemini 3.1 Flash Lite,以 Google 搜尋作為依據 |
| Perplexity | Sonar |
資料分成兩組市場。主資料集是美國家用網路,651 個問題、143,249 則回答、396,188 筆引用;第二組是建築與工程業使用的提案軟體,屬於由小型廠商組成的利基市場,55 個問題、14,850 則回答、71,849 筆引用。兩組都在 2026 年 6 月 24 日至 9 月 21 日間每日收集。
三個引擎的引用行為差異很大:
| 主資料集 | ChatGPT | Gemini | Perplexity |
|---|---|---|---|
| 每則回答平均引用頁數 | 2.0 | 10.1 | 0.3 |
| 沒有任何引用的回答 | 30.8% | 15.6% | 95.8% |
| 引用指向品牌自家網站的比例 | 64.3% | 16.8% | 6.8% |
Gemini 的引用有 83% 指向第三方網站,其中 Reddit 佔 13%;ChatGPT 則有六成以上直接引用品牌官網。
研究的核心設計稱為「網站內比較」:每一頁只跟同網站的其他頁面相比。為了避免偶然的顯著結果,一項特徵必須同時通過五種檢定(多重比較校正、重複抽樣下的穩定入選、機器學習估計、效果曲線形狀、多種資料切法下方向一致),才被認定為真的有關。
FAQ、Schema 與作者框:跨網站與同網站比較的落差
跨網站比較時,論文的結果與一般的 GEO 建議相符。下表的「速度」以一個標準差(衡量差距大小的統計單位,可理解為「快了明顯一截」)計算,其餘為有無之比:
| 做法 | 跨網站比較 | 同網站內比較 |
|---|---|---|
| FAQ 區塊 | +18.1% | −3.4%,不顯著 |
| 摘要框(TL;DR、重點整理) | +20.9% | +6.9%,不顯著 |
| 作者資訊 | +14.9% | −4.6%,不顯著 |
| Schema 結構化資料 | +7.5% | −5.3%,不顯著 |
| 頁面速度 | +11.7% | 不顯著 |
跨網站比較的數字全部顯著,改成同網站內比較後沒有任何一項顯著。原因在於做法集中的位置:被引用最多的前四分之一網站,有 43% 的頁面帶 FAQ 區塊;被引用最少的後四分之一只有 23%。FAQ 與「被引用得多」同時出現,是因為兩者都集中在同一批網站,不是因為 FAQ 本身帶來引用。統計上稱為辛普森悖論(分組後各組的趨勢,與合併計算時的趨勢相反或消失)。
第二組利基市場重現了同樣的模式,FAQ 區塊跨網站 +22.5%、網站內 −1.9%。
在 ChatGPT 決定引用哪幾頁的階段,論文另外比較了檢索排名相同的頁面:作者框(勝算比 0.77,勝算比低於 1 表示被引用的機會較低)、FAQ 區塊(0.93)、Schema(0.92)的頁面被引用的機會都略低。
論文量的是「AI 引用次數」,Schema 在 Google 搜尋結果的複合式結果(rich results)與實體辨識上的作用不在這次的研究範圍內。研究也沒有證明這些做法有害,只是在排除網站差異後,找不到它們讓 AI 引用變多的證據。
與 AI 引用相關的頁面特徵:標題與段落對準提問
十四項頁面特徵中,通過全部五項檢定的只有兩項,都和「頁面是否回答了使用者實際的提問」有關:
- 最相關段落與提問的語意相似度每高一個標準差,引用次數多 15.5%
- 標題與提問的語意相似度每高一個標準差,引用次數多 14.1%
- 只看第三方網站的頁面,這兩項分別是 25.7% 與 23.6%
文章長度、外部連結數、標題數量、清單、表格都沒有效果。頁面越舊引用越少(每一個標準差 −5.1%),但這項未能穩定通過檢定。
最相關的那一段在頁面中的位置,中位數落在全文 45% 處,只有 32% 的被引用頁面把它放在前四分之一,引擎在頁面任何位置都找得到,與「答案一定要寫在開頭」的常見建議不同。標題對準提問這一項,對 Gemini(+16.8%)有效,對 ChatGPT 則幾乎是零,原因是 ChatGPT 會把問題改寫成自己的搜尋詞,不直接拿原句去比對。
這些相似度只解釋了一小部分差異。在 ChatGPT 的引用中,所有頁面特徵加起來只能解釋同網站頁面之間 2.8% 的差異。把同一組資料按奇偶日拆開計算,約 75% 的差異會重複出現,卻無法以任何頁面特徵解釋,代表引用並非隨機,而是由頁面以外的因素決定。
AI 檢索與 Google 排名的差異
剩下的差異,論文認為來自 AI 自己的檢索步驟。研究團隊把 651 個問題再透過 API 重跑一次,直接取得引擎發出的搜尋詞、取回的頁面清單與排序:
- ChatGPT 引用的頁面,100% 出現在它自己的檢索結果中(22,315 個被引用網址全部如此)。沒有被檢索到的頁面不會被引用
- 每個問題 ChatGPT 平均讀取 26 頁、引用 3 頁。檢索排第 1 的頁面有 43.8% 會被引用,第 6–10 名降到 12.2%,第 11–20 名只剩 3.5%
- 檢索的資料可以解釋 32% 的引用差異,頁面特徵只有 2.8%
ChatGPT 會把一個問題拆成約 4 個關鍵字式的搜尋詞,其中 23% 加上當年年份,28% 加入使用者沒有提到的品牌名稱;Gemini 則改寫成約 3 個接近原句的自然語言問句。同一天對同一問題跑兩次,ChatGPT 的搜尋詞只重疊 2.7%,引用頁面重疊 15%。這種「一個問題拆成多個搜尋」的機制,在〈ChatGPT 扇出查詢〉一文中有較完整的說明。
AI 檢索的結果與 Google、Bing 幾乎沒有重疊。ChatGPT 取回的頁面有 97% 不在 Google 前 50 名、99% 不在 Bing 前 30 名;Gemini 雖然以 Google 搜尋為依據,被引用的頁面仍有 93% 不在 Google 前 50 名。不過 ChatGPT 取回的頁面中,有一半(51%)所屬的網站有出現在 Google 前 50 名。兩邊挑的常是同一批網站,選中的頁面卻不同。
在 Google 排名靠前,不代表該頁會被 AI 選中;網站在搜尋端完全沒有能見度,則可能連進入候選的機會都沒有。
品牌知名度對 AI 推薦的影響
研究團隊也在關閉搜尋的情況下,直接詢問模型「這個問題你會推薦哪些品牌與網站」,以此量測模型的既有認知:
- ChatGPT 的引用中,有 47% 來自模型不經搜尋就能說出的網站
- 品牌若在模型的既有認知中,ChatGPT 有 67% 的機率會把它寫進搜尋詞,不在認知中的品牌只有 11%
- ChatGPT 提到使用者沒問的品牌時,有 46% 沒有任何被引用的頁面支持這個品牌名稱,屬於模型自己記得的
控制實驗把產品資料內容完全固定、只改品牌名稱,排名就會改變。同樣一份產品描述,換上不同的名字,進入 ChatGPT 前三名的比例可以從 39% 變成 80%。
利基市場的情況正好相反。研究中 ChatGPT 背後的模型,只在 2–16% 的問題中說得出這些小廠商的名字。這時第三方頁面的作用就大得多:被引用的第三方頁面若提到某家廠商,ChatGPT 在回答中提到該廠商的勝算提高 39.7 倍(主資料集的大品牌只有 4.2 倍)。論文的結論是,知名品牌的能見度大多由模型既有的認知決定;小品牌只有在搜尋找得到關於它的第三方證據時,才有穩定的位置。
與台灣 AI 引用實測的對照
搜霸在 2026 年 9 月以台灣的 SEO 與 GEO 問句做過一組公開實測:36 個問題、ChatGPT 與 Gemini 未登入的網頁介面、兩期各 216 次取樣,原始資料以 CC BY 4.0 公開在研究資料頁。兩份研究的語言、市場、介面與規模都不同,數字不能直接比較,但下列觀察的方向一致。
ChatGPT 對知識型問題較少查資料。台灣實測中,ChatGPT 回答操作與觀念類問題時,只有 3.7% 列出外部來源,Gemini 為 66.7%。論文的利基市場幾乎全是「了解功能」類的問題,ChatGPT 只有 35% 的回答附引用,主資料集則是 69%。兩邊的數字差距很大,但都顯示 ChatGPT 面對知識型問題時更常直接以模型知識作答。
推薦型問題的引用集中在第三方名單。台灣實測中,「推薦 SEO 公司」這類問題的引用,主要來自人力銀行、電商平台的內容頁,以及同業撰寫的推薦清單文。台灣的 SEO 服務商多屬模型不熟悉的小品牌,情況接近論文的利基市場,而論文量到第三方頁面在這類市場的影響最大。兩份資料都指向同一個做法:進入別人的名單,比自己再寫一篇同型清單更有機會出現在回答裡。
引用來源變動快,但頭部網域相對穩定。台灣實測兩期相隔 13 天,被引用的 216 個網域中只有 36.6% 兩次都出現,變動集中在長尾。論文以 14 天為一期切分,兩週後 ChatGPT 仍共通的變異約 40%、Gemini 47%,十週後降到 14% 與 29%。兩邊的計算單位不同,但都顯示單一時間點的觀測無法代表常態。
FAQ 與 Schema 的結論目前沒有中文環境的對照資料。台灣實測的題數與取樣次數不足以做網站內比較,這部分仍待驗證。
研究限制與利益揭露
論文自己列出的限制包括:結果是相關性,網站內比較排除了網站層級的差異,但排除不了同網站頁面之間未被量測的差異;頁面是在收集結束後才下載的,約三分之一的被引用網址無法分析;重跑檢索使用的是 API,未必與一般使用者看到的 ChatGPT、Gemini 介面一致;兩組資料都是英文、美國市場的問題。
研究使用的是 GPT-5.4 nano 與 Gemini 3.1 Flash Lite 這類小型模型,消費者產品背後的模型與檢索設定可能不同。問題由使用研究團隊監測平台的客戶撰寫,並非從真實使用者的搜尋紀錄抽樣。資料收集平台由作者經營,致謝中也感謝了 ktau.ai 團隊,而論文的建議之一正是「長期、逐題監測引用」。這不影響方法本身的嚴謹度,但讀者應知道這層關係。論文目前為 arXiv 預印本,尚未經過同儕審查。
網站內比較的設計本身也有盲點:若一個網站以模板替所有頁面加上 Schema,該網站內就沒有「有 Schema」與「沒有 Schema」的頁面可以比較,這個網站對 Schema 的估計貢獻不到任何資訊。論文也提到,品牌網站多以共用模板建置,網站內的差異較小,沒有任何特徵在品牌頁面通過全部五項檢定。「網站內比較沒有效果」不等於「整站導入沒有效果」。目前沒有證據顯示這些做法能讓同一網站的某一頁被引用得更多,整站導入的效果則無法以這個設計判斷。
對 GEO 內容配置的實務意義
頁面寫法以對準提問為優先。 標題與段落是否直接回答使用者實際提出的問題,是唯一通過全部檢定的頁面因素。關鍵段落不必刻意放在開頭,但要有一段能單獨回答問題。
FAQ、Schema、作者框不是取得 AI 引用的捷徑。 這些做法有其他用途,例如複合式搜尋結果、實體辨識與讀者信任,可以照常做,但不應期待單獨加上 FAQ 區塊就讓某一頁被 AI 引用。
被檢索到比頁面修飾更重要。 AI 只引用它檢索到的頁面,而它的檢索與 Google 排名幾乎不重疊。網站在搜尋端要先有基本的能見度,再以內容對準 AI 改寫後的搜尋詞,例如帶年份、帶品牌名稱的查詢。
小品牌要經營第三方提及。 模型不認識的品牌,靠的是第三方頁面提到它。出現在產業名單、評比文章、媒體報導中,效果比在自家網站多做一層標記更大。
監測要分引擎、分問題、長期進行。 單次查詢、單一引擎的結果都不具代表性。
參考來源
- Mahe Chen, Nick Koudas(2026)。What Drives AI Citations? Content, Retrieval and Model Knowledge in Generative Engine Optimization (GEO)。arXiv:2610.15033
- 搜霸 SEOBAR(2026)。AI SEO/GEO 實測:ChatGPT 與 Gemini 引用來源重疊 17.8%
- 搜霸 SEOBAR(2026)。AI 引用來源實測資料集(2026-09)
常見問題
加上 FAQ 區塊或 Schema,能讓頁面更容易被 AI 引用嗎?
依多倫多大學 2026 年 10 月的研究,目前沒有證據支持。跨網站比較時,有 FAQ 區塊的頁面引用多 18.1%、有 Schema 的多 7.5%;改成同一網站內的頁面互相比較後,兩者都不顯著。差距來自採用這些做法的多半是本來就常被引用的網站。研究範圍只涵蓋 AI 引用次數,不包含 Schema 在 Google 複合式搜尋結果與實體辨識上的作用。
哪些頁面特徵與 AI 引用有關?
研究檢驗的十四項特徵中,只有標題與最相關段落是否對準使用者的提問通過全部五項檢定:段落相似度每高一個標準差,引用多 15.5%;標題多 14.1%。文章長度、外部連結、標題數量、清單與表格都沒有效果。
Google 排名高,AI 就會引用嗎?
不一定。研究中 ChatGPT 檢索到的頁面有 97% 不在 Google 前 50 名,Gemini 被引用的頁面也有 93% 不在 Google 前 50 名。兩者常挑同一批網站,但選中的頁面不同。ChatGPT 只引用它自己檢索到的頁面,檢索結果可解釋 32% 的引用差異,頁面特徵只有 2.8%。
小品牌要怎麼增加被 AI 推薦的機會?
研究中的利基市場顯示,模型不熟悉的小品牌主要靠第三方頁面被提及:被引用的第三方頁面若提到某家廠商,ChatGPT 在回答中提到該廠商的勝算提高 39.7 倍。台灣的實測也觀察到,推薦型問題的引用集中在人力銀行、電商平台與同業撰寫的推薦清單。
這份研究的結論適用於台灣與中文內容嗎?
需要保留。研究使用英文、美國市場的問題,以 API 與小型模型重跑檢索,未必與消費者看到的 ChatGPT、Gemini 一致。對照台灣消費介面的實測,引擎之間的差異、推薦型問題倚重第三方名單、引用來源快速流動三項方向一致;FAQ 與 Schema 的結論則尚無中文環境的對照資料。
網站一直搜不到,想知道卡在哪一關?
抓取、索引、排名、AI 引用是四道不同的關卡,卡在哪一關決定要做什麼。把網址給我,我用實際量測看一遍再跟你說。
技術 SEO 分類其他文章
繼續閱讀同主題的延伸內容
留言討論
只有會員能留言(防止垃圾訊息),留言顯示於此頁。